Pourquoi l'IA invente des réponses, et comment l'éviter
Sur cette page
- L'essentiel
- D'où vient le chiffre que tout le monde cite, et que vaut-il ?
- Que mesure réellement un taux d'hallucination ?
- Que se passe-t-il quand on retire le document ?
- Qu'est-ce qui réduit le phénomène, selon les éditeurs eux-mêmes ?
- Le droit impose-t-il que l'IA dise vrai ?
- Comment vérifier une réponse en pratique ?
- À lire également
- FAQ
Les pages francophones consacrées aux hallucinations de l'IA annoncent depuis un an des taux inférieurs à 1 %, et citent régulièrement 0,7 % pour un modèle de Google. Ce chiffre provient d'une version du classement Vectara arrêtée le 16 octobre 2025, dont le protocole reposait sur 831 dépêches courtes du corpus CNN et Daily Mail. Sur le corpus en vigueur, relevé le 19 août 2026, qui compte plus de 7 700 articles allant de 50 à 24 000 mots et couvre le droit, la médecine, la finance et les sciences, le meilleur modèle est à 1,8 % et l'essentiel du marché se situe entre 5 % et 15 %.
Corriger le chiffre ne suffit pourtant pas, parce que même le bon chiffre ne dit pas ce que le lecteur croit. Ce classement mesure la fidélité d'un résumé au document qui a été fourni au modèle, et son éditeur écrit noir sur blanc qu'un système se contentant de recopier des phrases du texte obtiendrait un score parfait. La question utile n'est donc pas de savoir quel modèle hallucine le moins, mais de quelle hallucination on parle, puisqu'il en existe au moins quatre familles et qu'elles se mesurent séparément, avec des résultats opposés.
Cet article détaille d'où vient le chiffre que tout le monde cite et ce qu'il vaut, ce qu'un taux d'hallucination mesure réellement, ce qui se passe quand on retire le document de la question, les mécanismes que les éditeurs documentent pour réduire le phénomène et les limites qu'ils déclarent eux-mêmes, ce que le droit impose en matière d'exactitude, et la procédure de vérification à installer cette semaine.
L'essentiel
Un taux d'hallucination n'a de sens qu'attaché à une tâche précise. Le classement le plus cité mesure l'écart entre un résumé et un document fourni, ce qui prédit assez bien le comportement d'un outil branché sur une base documentaire d'entreprise, et ne dit rien de la fiabilité d'une réponse donnée de mémoire. Quand on retire le document, les ordres de grandeur changent complètement : sur une évaluation sans contexte ni outil publiée en novembre 2025, trois modèles sur trente-six seulement répondaient juste plus souvent qu'ils ne répondaient faux. Aucun mécanisme documenté par les éditeurs n'élimine le phénomène, un seul d'entre eux l'écrit explicitement, et aucun texte européen n'impose à ce jour d'obligation générale d'exactitude. La sanction, elle, existe déjà, et elle tombe au moment de la signature.
D'où vient le chiffre que tout le monde cite, et que vaut-il ?
D'un dépôt public tenu par l'éditeur américain Vectara, dont la version en vigueur est bien plus sévère que celle qui circule en français, et dont la colonne la plus intéressante n'est jamais reprise.
Le classement des hallucinations de Vectara évalue les modèles sur une tâche unique : résumer un document qui leur est fourni, en n'utilisant que ce document. La version actuelle repose sur le modèle d'évaluation HHEM-2.3 et porte la mention d'une dernière mise à jour au 11 mai 2026, confirmée par l'historique des contributions du dépôt et inchangée au relevé du 19 août 2026. Les chiffres inférieurs à 1 % qui circulent proviennent d'une branche archivée, arrêtée le 16 octobre 2025, dont le corpus se limitait à 831 dépêches courtes.
| Modèle | Taux d'hallucination | Taux de réponse |
|---|---|---|
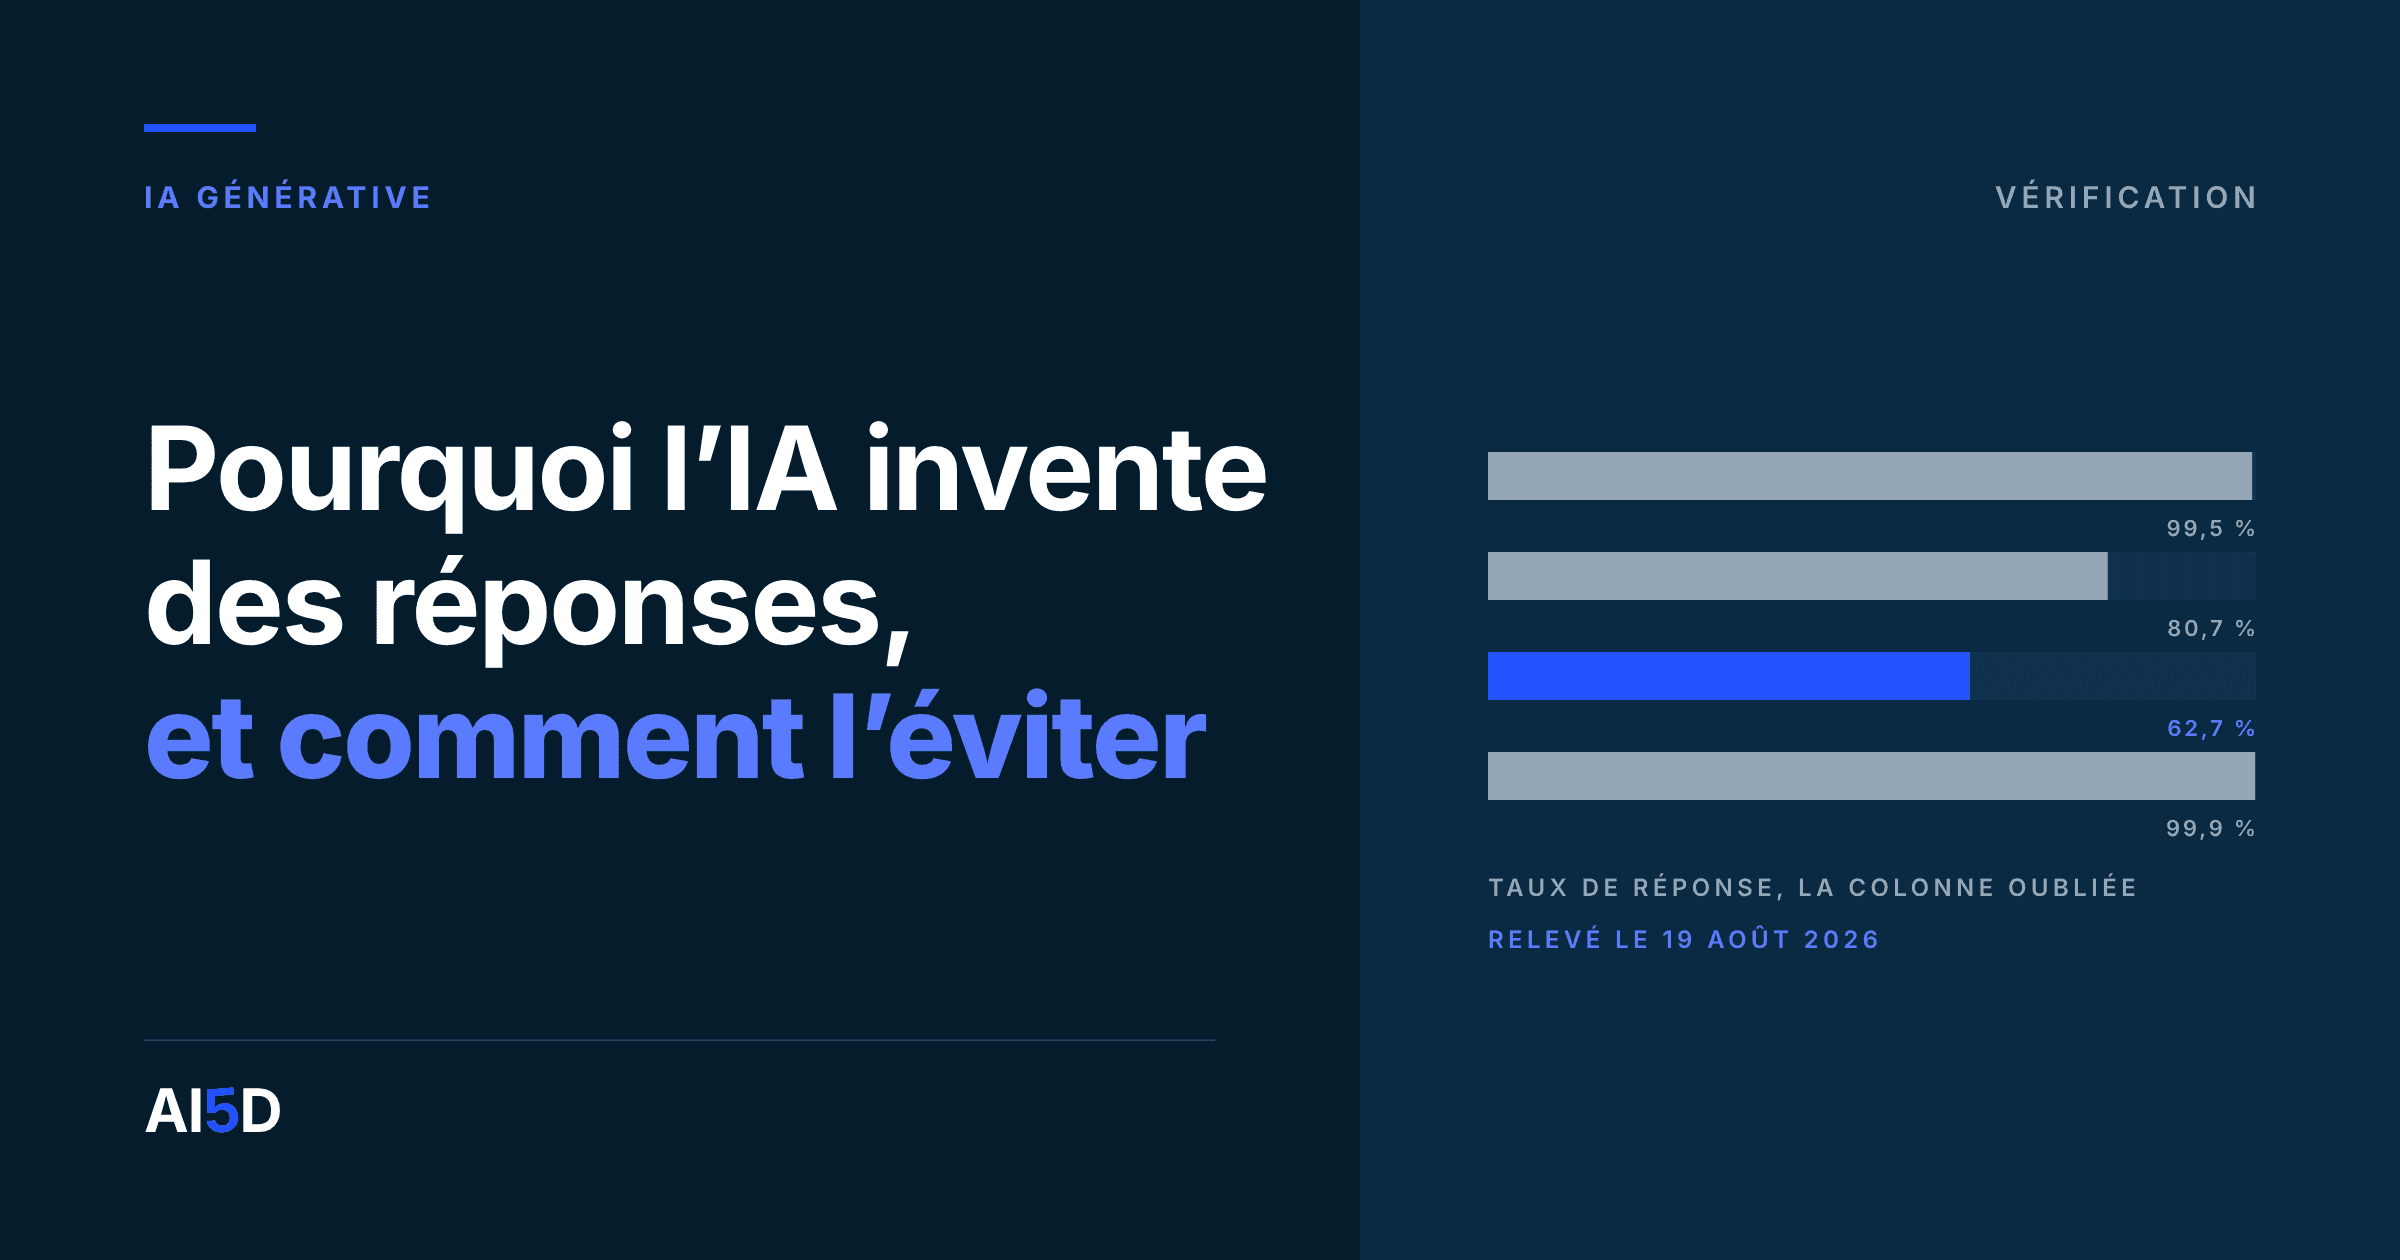
| antgroup/finix_s1_32b | 1,8 % | 99,5 % |
| openai/gpt-5.4-nano | 3,1 % | 100,0 % |
| google/gemini-2.5-flash-lite | 3,3 % | 99,5 % |
| microsoft/Phi-4 | 3,7 % | 80,7 % |
| meta-llama/Llama-3.3-70B-Instruct-Turbo | 4,1 % | 99,5 % |
| snowflake/snowflake-arctic-instruct | 4,3 % | 62,7 % |
| mistralai/mistral-large-2411 | 4,5 % | 99,9 % |
| openai/gpt-5.5 | 9,3 % | 100,0 % |
| anthropic/claude-sonnet-4-6 | 10,6 % | 99,9 % |
| anthropic/claude-opus-4-7 | 12,0 % | 98,0 % |
| xai-org/grok-4-fast-reasoning | 20,2 % | 99,5 % |
| openai/o3-pro | 23,3 % | 100,0 % |
Source : Vectara, Hallucination Leaderboard, HHEM-2.3, mis à jour le 11 mai 2026, relevé le 19 août 2026.
La colonne de droite est celle qui change la lecture, et elle est absente de tous les articles francophones consultés. Un modèle n'est évalué que sur les documents qu'il accepte de résumer : Phi-4 obtient sa quatrième place en refusant un document sur cinq, et Snowflake Arctic sa sixième en refusant plus d'un document sur trois. Un modèle qui se tait souvent affiche mécaniquement un bon score, ce qui rend le taux d'hallucination inutilisable seul.
Deux observations complètent le tableau, et toutes deux contredisent l'intuition. La première est que la hiérarchie ne suit pas celle de la puissance : un modèle de 32 milliards de paramètres arrive en tête, tandis que des modèles de raisonnement bien plus coûteux figurent au delà de 20 %. La seconde est qu'à l'intérieur d'une même famille, la variante à effort de raisonnement élevé fait moins bien que la variante à effort réduit, avec des résumés nettement plus longs. Le dépôt ne fournit aucune explication causale de ce phénomène, et il faut se garder d'en inventer une : c'est une corrélation constatée, rien de plus.
Un dernier point de méthode mérite d'être connu avant de citer ces nombres. Le corpus n'est pas public, délibérément, pour éviter que les modèles ne s'y ajustent, ce qui rend le classement non reproductible par un tiers. L'évaluation finale ne porte que sur les documents résumés par tous les modèles, et ce nombre n'est pas publié : écrire que les modèles ont été testés sur 7 700 documents serait donc inexact. Enfin, le juge est lui-même un modèle, un classifieur de 184 millions de paramètres, dont Vectara précise qu'il ne classe pas les hallucinations avec 100 % d'exactitude. Les écarts inférieurs à un point ne sont pas interprétables.
Que mesure réellement un taux d'hallucination ?
La fidélité d'un résumé au document fourni, et rien d'autre. Ce n'est ni la véracité générale, ni la qualité du résumé, et l'éditeur du classement le dit lui-même avec une franchise que ses commentateurs ne reprennent jamais.
Nous n'évaluons pas la qualité des résumés, uniquement leur cohérence factuelle. Un modèle purement extractif n'aurait par définition aucune hallucination et produirait un résumé fidèle. Nous ne recommandons pas d'utiliser ceci comme une métrique autonome.
La conséquence de cette réponse est plus forte qu'elle n'en a l'air : le meilleur score possible n'est pas le meilleur comportement possible. Un système qui recopierait les phrases du document sans rien synthétiser obtiendrait zéro pour cent, tout en étant parfaitement inutile. Le classement mesure la retenue, pas l'utilité, et il faut donc le lire comme un indicateur de risque et jamais comme un palmarès de qualité.
Vectara explique aussi pourquoi il a choisi cette tâche plutôt que la véracité générale, et l'argument vaut d'être compris parce qu'il éclaire tout le sujet. Déterminer si une réponse quelconque est fausse supposerait de savoir précisément sur quelles données chaque modèle a été entraîné, et de disposer d'un juge capable de trancher sans document de référence, c'est à dire d'un système qui aurait déjà résolu le problème qu'on cherche à mesurer. L'éditeur contourne cette impasse en fournissant un document et en mesurant l'écart à ce document, et il présente sa mesure comme un analogue de la véracité, jamais comme sa mesure.
Une zone grise mérite enfin d'être signalée, parce qu'elle est reconnue par Vectara et jamais rapportée. La consigne donnée aux modèles leur interdit explicitement d'inférer et d'utiliser leur connaissance interne. Quand un modèle ajoute une information absente du document, on ne sait donc pas s'il a inventé ou s'il a simplement désobéi à la consigne. Le taux affiché mélange deux phénomènes distincts, l'invention et le manquement à l'instruction, ce que l'éditeur assume au motif que les deux se valent en pratique.
Que se passe-t-il quand on retire le document ?
Les ordres de grandeur changent complètement, et c'est la démonstration la plus utile qu'un dirigeant puisse retenir de tout ce dossier.
L'évaluation AA-Omniscience, publiée le 17 novembre 2025 par Artificial Analysis, pose 6 000 questions couvrant 42 sujets professionnels dans six domaines, et précise que les modèles sont interrogés sans aucun contexte ni accès à un outil, afin de mesurer leur capacité brute à restituer des faits. Son indice principal est construit de façon que zéro corresponde à un modèle qui répond juste aussi souvent qu'il répond faux. Le résultat publié est que trois modèles sur trente-six seulement dépassaient zéro, le meilleur atteignant 4,8.
3 sur 36
modèles répondant juste plus souvent que faux, sans document ni outil, novembre 2025
moins de 70 %
exactitude globale du meilleur modèle sur la suite FACTS, décembre 2025
environ 1 %
articles de NeurIPS 2025 portant au moins une citation inventée confirmée
La suite FACTS, publiée par Google DeepMind le 9 décembre 2025, apporte la seconde pièce et une clarification conceptuelle précieuse. Elle sépare explicitement quatre choses que le public confond : la connaissance de mémoire, la capacité à chercher correctement sur le web, l'exactitude sur des questions portant sur une image, et la fidélité à un document fourni. Chacune fait l'objet d'un jeu de test distinct, et le verdict d'ensemble est que tous les modèles évalués restaient sous 70 % d'exactitude globale, alors même que la suite inclut le volet recherche et le volet ancrage documentaire.
Le troisième mode de défaillance, celui des références inventées, n'est mesuré par aucun de ces deux dispositifs. Le seul chiffre solide disponible vient d'une analyse publiée le 21 janvier 2026, portant sur 4 841 des 5 290 articles acceptés à la conférence NeurIPS 2025 : cent citations inventées confirmées, chacune vérifiée à la main par un expert, réparties sur un peu plus de cinquante et un articles. Cela représente environ 1 % des articles examinés, et le fait marquant n'est pas le volume mais le fait que ces articles avaient tous franchi une relecture par les pairs. Le sujet est la défaillance du contrôle, pas l'invasion.
Un dernier point, qui vaut avertissement pour un lecteur francophone : aucune de ces trois mesures ne teste le français. Vectara indique que son modèle d'évaluation ouvert ne couvre que l'anglais, et AA-Omniscience déclare en limite que toutes ses questions sont en anglais. Les taux publics couramment cités décrivent donc un comportement en anglais, et rien d'autre.
Qu'est-ce qui réduit le phénomène, selon les éditeurs eux-mêmes ?
Fournir le document, exiger la citation, et autoriser le modèle à ne pas savoir. Ces trois leviers sont documentés par les éditeurs, et le plus instructif est de lire ce qu'ils déclarent comme limites.
La page qu'Anthropic consacre à la réduction des hallucinations donne la liste la plus complète et la plus opérationnelle. Elle recommande d'autoriser explicitement le modèle à admettre son incertitude, technique que l'éditeur présente comme réduisant fortement les fausses informations. Elle recommande, pour les documents dépassant vingt mille jetons, de faire d'abord extraire les citations mot pour mot avant tout traitement. Elle recommande de rendre la réponse auditable en exigeant une citation par affirmation, et de faire rétracter toute affirmation pour laquelle aucune citation n'a été trouvée. Elle mentionne enfin l'exécution répétée d'une même demande, les incohérences entre exécutions signalant les passages douteux.
| Éditeur et mécanisme | Ce qui est garanti | La limite déclarée |
|---|---|---|
| Anthropic, conseils anti-hallucination | rien | elles ne les éliminent pas entièrement |
| Anthropic, citations | un pointeur valide vers le document fourni | ni images, ni PDF scannés, incompatible avec les sorties structurées |
| OpenAI, recherche web | des citations cliquables, obligatoires à l'affichage | aucune limite d'exactitude déclarée sur la page |
| OpenAI, recherche de fichiers | une citation avec l'index du caractère | les résultats ne sont pas renvoyés par défaut |
| Google, vérification d'ancrage | un score de 0 à 1 | approxime grossièrement la part d'affirmations ancrées |
| Microsoft, détection d'ancrage | une détection et une correction en préversion | anglais uniquement, aucune métrique de performance publiée |
| Mistral, citations | des références structurées | aucune limite déclarée |
Sources : pages de documentation officielles de chaque éditeur, relevées le 19 août 2026.
Deux enseignements sortent de ce tableau, et ils sont plus utiles que n'importe quel classement. Le premier est qu'un seul éditeur écrit explicitement que ses techniques n'éliminent pas le phénomène, et qu'il l'écrit sur sa page de conseils de rédaction, pas sur ses pages produit : les pages qui vendent un mécanisme de vérification ne portent, chez aucun des cinq, d'avertissement sur l'exactitude.
Le second est une nuance décisive sur les citations, régulièrement mal comprise. Quand Anthropic écrit que ses citations contiennent des pointeurs valides vers les documents fournis, la garantie porte sur l'intégrité du pointeur, jamais sur la vérité de l'affirmation. Une citation peut renvoyer à un passage réellement présent et le déformer, et rien dans le dispositif ne l'empêche. C'est exactement la famille d'erreurs que notre article sur les limites de l'IA générative identifie comme la plus coûteuse, celle dont la forme reste irréprochable.
Le droit impose-t-il que l'IA dise vrai ?
Non, et c'est probablement l'information la plus utile de cet article pour une direction. Aucune obligation générale d'exactitude des contenus générés n'existe à ce jour, ni en droit européen ni en droit français.
Le règlement européen sur l'intelligence artificielle impose du marquage et de l'information, pas de la véracité. Les obligations de transparence applicables depuis le 2 août 2026, détaillées dans notre article sur le calendrier réel de l'AI Act, portent sur le fait de signaler qu'un utilisateur interagit avec un système d'IA et de marquer les contenus de synthèse. L'exigence d'un niveau approprié d'exactitude existe bien dans le texte, mais elle ne vise que les systèmes classés à haut risque, dont les obligations s'appliqueront au 2 décembre 2027 ou au 2 août 2028 selon les cas. Le règlement charge par ailleurs la Commission de faire développer des référentiels de mesure de cette exactitude, ce qui revient à exiger de déclarer une valeur avant que la méthode pour la calculer n'existe.
Une disposition mérite d'être connue des organisations qui publient. Le règlement impose de divulguer qu'un texte a été généré ou manipulé par une IA lorsqu'il est publié dans le but d'informer le public sur des questions d'intérêt public, mais il prévoit une exception explicite lorsque le contenu a fait l'objet d'une revue éditoriale humaine et que quelqu'un en assume la responsabilité éditoriale. La relecture humaine n'est donc pas seulement une bonne pratique : elle est le fait générateur de l'exception.
Deux régulateurs sectoriels européens sont allés plus loin que le texte général, et leurs recommandations sont directement réutilisables. L'autorité européenne des marchés financiers, dans une déclaration publique du 30 mai 2024, reconnaît explicitement que les modèles hallucinent et demande aux entreprises d'investissement des contrôles ex ante sur l'exactitude des informations fournies aux systèmes, et des contrôles ex post suffisamment fréquents sur tout processus délivrant de l'information par un mécanisme piloté par l'IA. Elle rappelle aussi que les décisions restent la responsabilité des organes de direction, qu'elles soient prises par des personnes ou par des outils. L'Agence européenne des médicaments, dans des principes directeurs du 29 août 2024, recommande de proportionner l'intensité de la relecture au risque, et de demander au système de citer les phrases exactes du document fourni afin qu'elles puissent être contrôlées.
Comment vérifier une réponse en pratique ?
En imposant la citation au moment de la demande plutôt qu'en relisant après coup, parce que la relecture valide une erreur bien présentée. Trois gestes suffisent, et le premier tient dans un texte à copier.
Exigez la citation dans la demande elle-même, et non en question de suivi. Un modèle sommé de justifier après coup produit des justifications ; un modèle contraint de citer avant d'affirmer renonce plus souvent.
Réponds uniquement à partir du document fourni ci-dessous. N'utilise pas tes connaissances générales.

Pour chaque affirmation de ta réponse :
- cite entre guillemets le passage exact du document sur lequel elle repose ;
- si aucun passage ne la soutient, ne formule pas l'affirmation.

Si le document ne permet pas de répondre, écris exactement : « Le document ne permet pas de répondre à cette question », et arrête-toi là. Ne complète pas par ce que tu sais par ailleurs.

Termine par une section « Ce que le document ne dit pas » listant les points de ma question restés sans réponse.

Document : [collez ici le document]
Question : [votre question]
Vérifiez par recalcul ou par retour à la source, jamais par lecture. Un chiffre se recalcule, une référence s'ouvre, une date se confronte à la page d'origine. Une relecture attentive ne détecte pas une erreur dont la forme est correcte, et c'est la raison pour laquelle la vérification doit être une action et non une impression.
Nommez la personne qui signe. C'est la leçon que trois juridictions ont tirée en six mois, et elle s'applique bien au delà du droit : la responsabilité ne se déplace pas vers l'outil, elle se concentre au moment où quelqu'un valide. Une organisation qui n'a pas désigné ce quelqu'un pour chaque type de livrable n'a pas de dispositif, elle a une habitude. C'est le premier point que nous établissons avec nos clients quand un usage documentaire se met en place.
Ce que cet article établit tient en trois lignes. Les taux d'hallucination cités en français décrivent un protocole abandonné, et le protocole en vigueur mesure une tâche précise dont les résultats ne se transposent pas. Aucun mécanisme documenté n'élimine le phénomène, et un seul éditeur l'écrit. Le droit n'impose pas encore l'exactitude, mais les tribunaux sanctionnent déjà la signature sans vérification. Le geste à faire est donc de déplacer la vérification en amont, dans la consigne, plutôt qu'en aval, dans la relecture.
À lire également
- Ce que l'IA générative sait faire, et ce qu'elle ne sait pas : les quatre propriétés qui rendent une tâche indélégable, dont celle dont l'erreur ne se voit pas à la relecture.
- Les chiffres sur l'IA en Afrique sont faux : la même méthode appliquée aux statistiques régionales, et ce qu'il reste quand on remonte à la source.
- AI Act : le calendrier réel, et qui est vraiment concerné : les trois dates qui comptent et le barème des sanctions.
- Ce que vous pouvez automatiser dans votre activité de formateur : la veille documentaire et sa vérification d'adresses, poste par poste.
FAQ
Quel est le taux d'hallucination des IA en 2026 ?
Il n'y a pas de réponse unique, parce que le taux dépend entièrement de la tâche mesurée. Sur le classement Vectara relevé le 19 août 2026, qui mesure la fidélité d'un résumé à un document fourni, le meilleur modèle est à 1,8 % et la plupart se situent entre 5 % et 15 %. Sans document ni outil, une autre évaluation publiée en novembre 2025 montre que trois modèles sur trente-six seulement répondaient juste plus souvent que faux.
Pourquoi les chiffres inférieurs à 1 % circulent-ils encore ?
Parce qu'ils viennent d'une version du classement Vectara arrêtée le 16 octobre 2025, dont le corpus se limitait à 831 dépêches de presse courtes. Le corpus actuel compte plus de 7 700 articles allant jusqu'à 24 000 mots, sur des domaines techniques. Aucun modèle n'y descend sous 1,8 %.
Les modèles les plus puissants hallucinent-ils moins ?
Non, pas sur cette tâche. Un modèle de 32 milliards de paramètres est en tête du classement actuel, tandis que plusieurs modèles de raisonnement bien plus coûteux dépassent 20 %. À l'intérieur d'une même famille, la variante à effort de raisonnement élevé fait moins bien que la variante à effort réduit. Aucune explication causale n'est publiée par l'éditeur du classement.
Comment empêcher une IA d'inventer une réponse ?
Fournissez-lui le document plutôt que d'espérer qu'elle le connaisse, exigez une citation textuelle pour chaque affirmation, et autorisez-la explicitement à répondre qu'elle ne sait pas. Ces trois leviers sont recommandés par la documentation des éditeurs. Aucun ne supprime le phénomène : Anthropic est le seul à l'écrire noir sur blanc.
Suis-je responsable si une IA me fait publier une information fausse ?
Oui. Trois juridictions fédérales américaines ont sanctionné des avocats en 2026 pour des références inventées et déposées sans vérification, avec des sanctions allant jusqu'à six mois de suspension. Le raisonnement retenu vaut pour tous les métiers : la faute n'est pas d'avoir utilisé l'IA, elle est d'avoir signé sans vérifier.
Ces taux valent-ils pour le français ?
Non, et c'est une limite rarement signalée. Le modèle d'évaluation ouvert de Vectara ne couvre que l'anglais, et l'évaluation AA-Omniscience précise que toutes ses questions sont en anglais. Aucun des classements publics couramment cités ne mesure le comportement des modèles en français.
Pour aller plus loin
E-book : les outils IA qui comptent en 2026
Le panorama des outils qui meritent votre attention, et de ceux qui n'en meritent pas.
Telecharger l'e-bookKaramo Sylla
Fondateur d'AI5D
Karamo Sylla est ingenieur et consultant en intelligence artificielle, fondateur d'AI5D. Il accompagne les dirigeants et les organisations d'Afrique de l'Ouest dans leur transformation par l'IA, de la strategie a l'execution, et il est le createur du Protocole AI5D.