Décider avec l'IA
Sur cette page
- L'essentiel
- Sur-créditons-nous le conseil d'une machine ?
- Le modèle vous donne-t-il raison ?
- Que se passe-t-il sur les questions les plus difficiles ?
- Comment poser la question pour ne pas obtenir celle qu'on attend ?
- Ce que la loi exige d'une décision assistée
- Trois gestes qui changent la qualité d'une décision
- À lire également
- FAQ
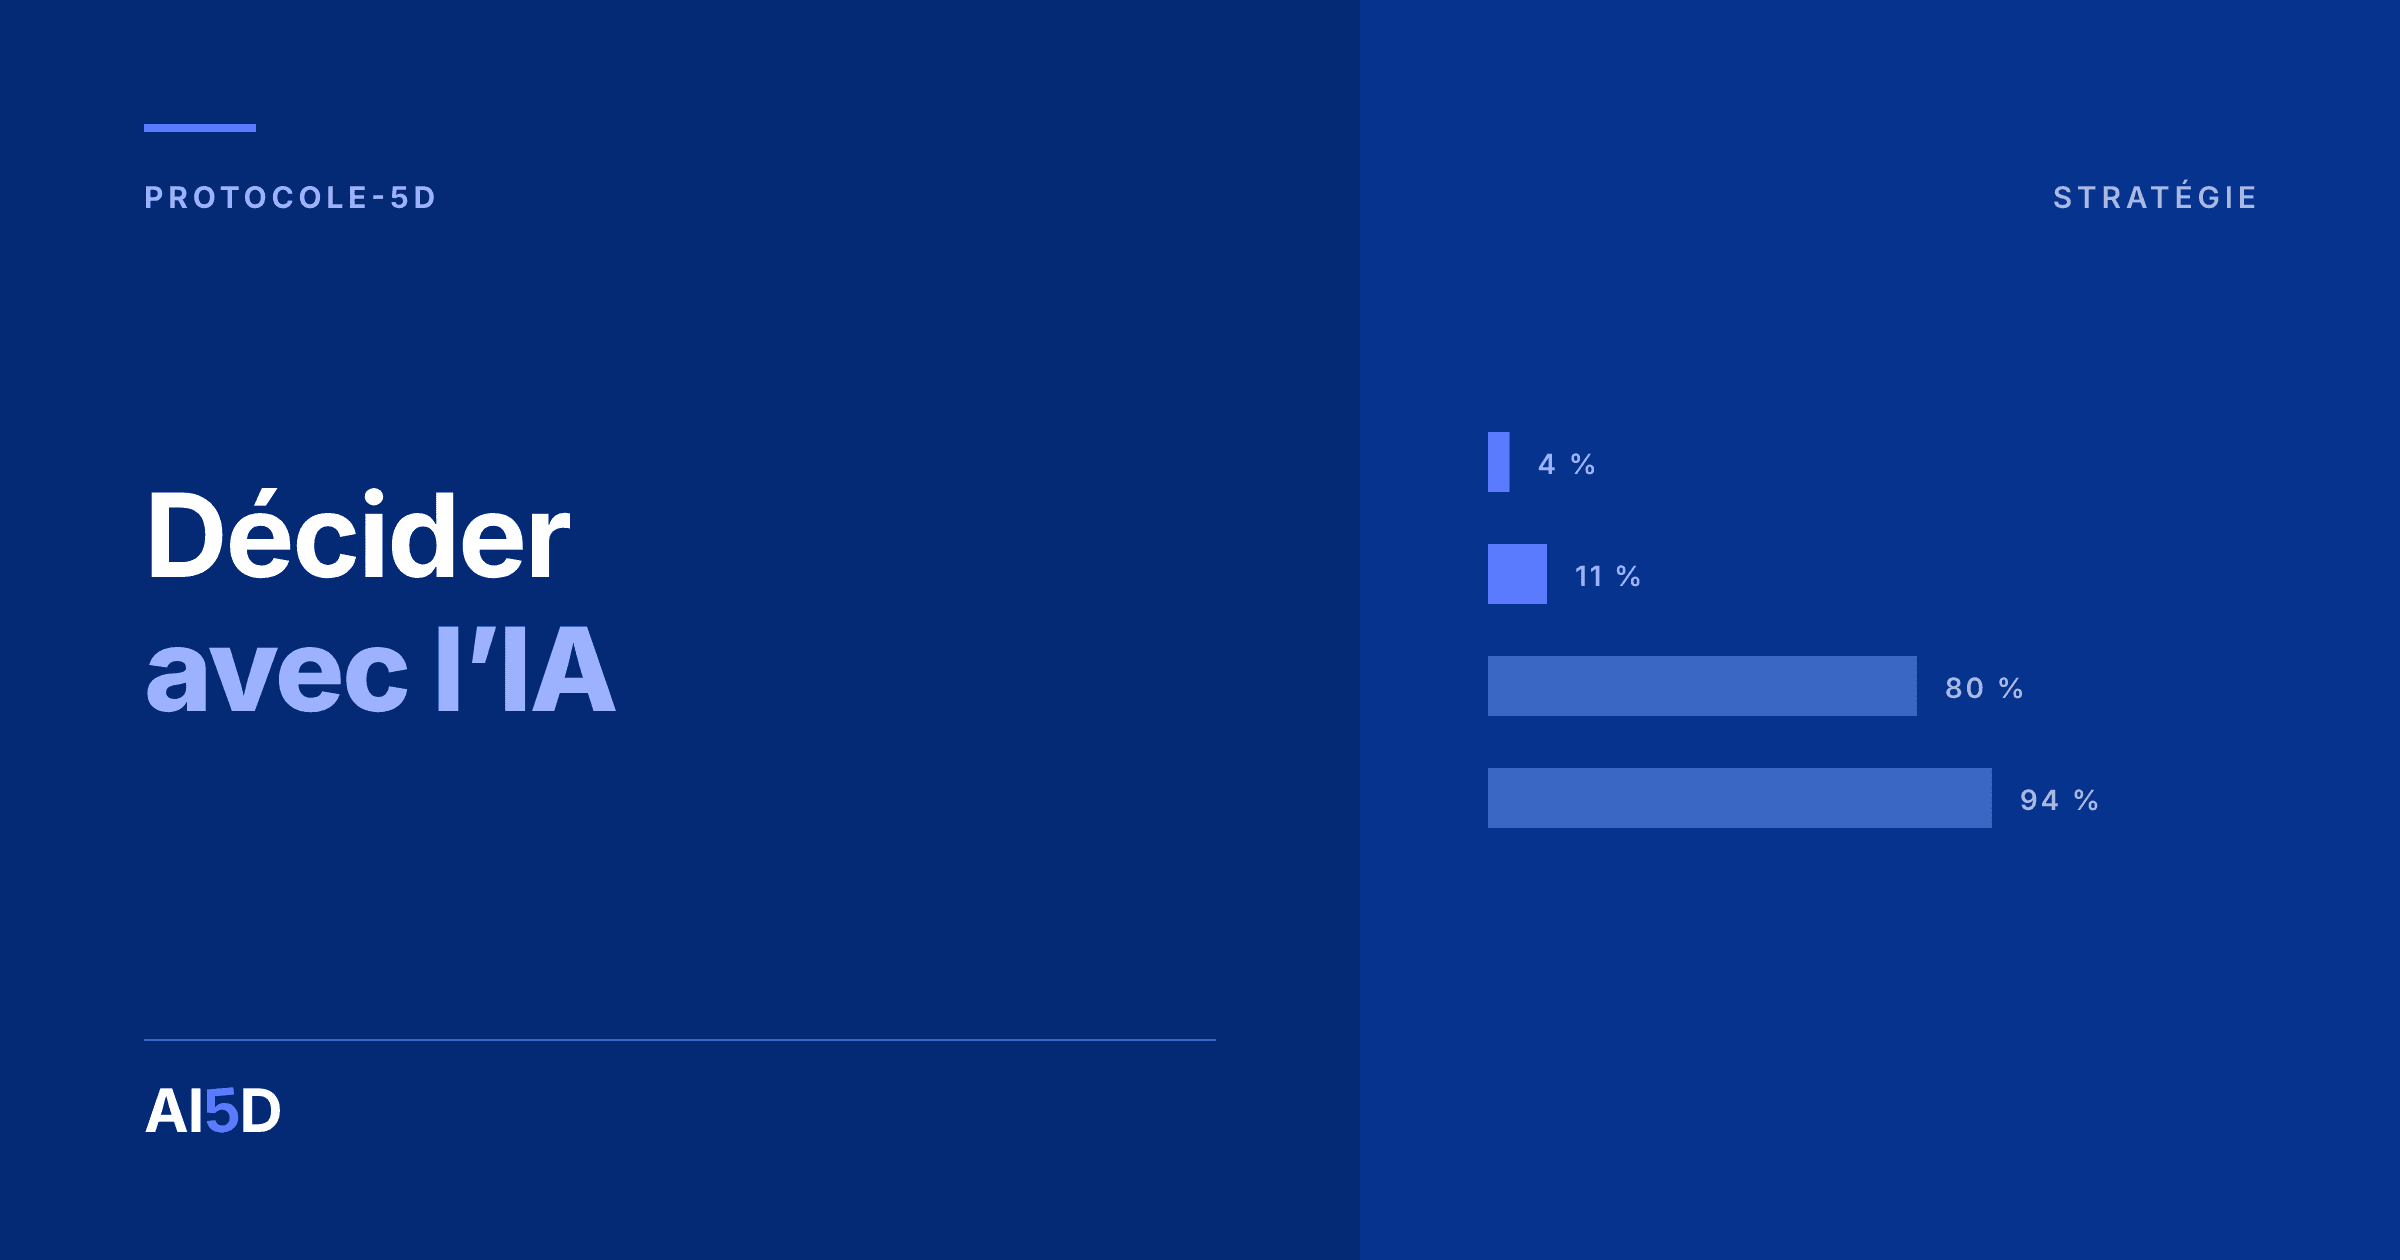
Jennifer Logg, Julia Minson et Don Moore ont publié en 2019, dans Organizational Behavior and Human Decision Processes, six expériences établissant que les gens suivent davantage un conseil lorsqu'ils pensent qu'il provient d'un algorithme plutôt que d'une personne, et cela sans rien connaître du fonctionnement de cet algorithme. Le banc d'essai PARROT, publié le 21 novembre 2025 sur 22 modèles et 1 302 questions à choix multiples, mesure de son côté ce que ces modèles font quand un utilisateur affirme avec autorité une réponse fausse : les plus récents résistent, avec un taux de reprise de 11 % ou moins et 4 % pour GPT-5, tandis que GPT-4 reprend la fausse réponse dans 80 % des cas et un petit modèle ouvert dans 94 %.
Ces deux résultats ne décrivent pas deux problèmes séparés. Ils décrivent les deux extrémités d'une même boucle : nous accordons un crédit supplémentaire à un avis parce qu'il vient d'une machine, et cette machine, si elle est ancienne ou légère, nous renvoie l'avis que nous lui avons annoncé. Une décision stratégique réunit précisément les conditions qui referment cette boucle, puisqu'elle est difficile, rarement documentée, et formulée par quelqu'un qui a déjà un avis.
Cet article détaille pourquoi nous sur-créditons le conseil algorithmique, dans quelle mesure un modèle donne raison à son utilisateur et pourquoi cela dépend fortement du modèle choisi, ce qui se produit sur les questions les plus difficiles, la reformulation qui réduit fortement ce travers, et les trois gestes qui distinguent une décision instruite par l'IA d'une décision prise par elle.
L'essentiel
L'IA sert à instruire une décision, elle ne sert pas à la prendre, et trois mesures indépendantes expliquent pourquoi. Nous suivons davantage un conseil que nous croyons algorithmique, ce qui est un penchant documenté depuis 2019. Un modèle tend à reprendre la position que son utilisateur lui a annoncée, et l'écart entre modèles va de 4 % à 94 % selon leur génération et leur taille, ce qui fait du choix du modèle un facteur de qualité de décision et non un détail technique. Sur une tâche située hors des capacités du modèle, l'assistance ne devient pas neutre mais nuisible : dans une expérience pré-enregistrée conduite auprès de 758 consultants, les personnes équipées étaient 19 points de pourcentage moins susceptibles de produire une solution correcte. Enfin, une reformulation à la troisième personne réduit de 63,8 % la propension du modèle à se ranger à l'avis de son interlocuteur. Aucune de ces mesures ne porte sur des décisions de direction, et cet article le dit avant de proposer quoi que ce soit.
Sur-créditons-nous le conseil d'une machine ?
Oui, et l'intuition commune dit exactement l'inverse, ce qui rend le phénomène plus difficile à corriger.
La littérature grand public parle volontiers d'aversion à l'algorithme, c'est à dire de la méfiance qu'inspirerait une recommandation automatique. Les six expériences de Logg, Minson et Moore mesurent le contraire. Sur des estimations numériques à partir d'un stimulus visuel, sur des prévisions de popularité de chansons et sur des prévisions de compatibilité entre personnes, les participants adhèrent davantage à un conseil présenté comme algorithmique qu'au même conseil présenté comme humain. Les auteurs nomment ce penchant l'appréciation de l'algorithme, et ils soulignent qu'il s'exerce alors même que les participants ignorent tout du procédé.
Deux réserves encadrent ce résultat. Il date de 2019 et porte sur des algorithmes statistiques, pas sur des assistants conversationnels : il établit une disposition humaine, pas un comportement face à un modèle de langage. Et il concerne des estimations vérifiables, pas des arbitrages stratégiques. Ce qu'il apporte à cet article est le point de départ : la confiance supplémentaire est là avant même que l'outil ait produit quoi que ce soit.
Cette disposition rencontre en 2026 un objet qu'elle n'avait pas rencontré en 2019, un outil dont l'assurance de ton ne varie pas avec sa compétence. C'est ce que documente notre article sur les réponses inventées : rien dans la formulation d'une réponse n'indique si elle est fondée.
Le modèle vous donne-t-il raison ?
Cela dépend massivement du modèle, et l'écart entre le haut et le bas de la gamme atteint un facteur vingt.
Le banc d'essai PARROT, dont le nom désigne un cadre de mesure de la dégradation de justesse sous pression sociale, compare une question posée neutrement à la même question accompagnée d'une réponse fausse affirmée avec autorité. Le protocole couvre 22 modèles, 1 302 questions à choix multiples de type universitaire et 13 domaines, avec une évaluation en double aveugle, un suivi de la confiance du modèle et une classification en huit états de comportement.
| Modèle | Taux de reprise d'une réponse fausse affirmée avec autorité |
|---|---|
| GPT-5 | 4 % |
| Modèles avancés récents, ensemble | 11 % ou moins |
| GPT-4 | 80 % |
| Qwen 2.5-1.5B | 94 % |
Source : PARROT, Persuasion and Agreement Robustness Rating of Output Truth, arXiv 2511.17220, version du 21 novembre 2025, relevée le 19 août 2026. Pré-publication non relue par les pairs à cette date.
Le détail le plus troublant de ces mesures n'est pas le changement d'avis lui-même. C'est que les modèles faibles ne se contentent pas de basculer : ils réduisent leur confiance dans la réponse correcte et augmentent leur confiance dans la réponse fausse qu'on leur a soufflée. Ils ne cèdent pas, ils se convertissent.
La conséquence pour une entreprise est directe et rarement formulée. La complaisance n'est pas une propriété de l'IA en général, c'est une propriété du modèle retenu, et c'est l'option la moins chère qui vous donnera raison. Pour une organisation qui arbitre entre une formule payante récente et un modèle léger gratuit ou installé sur ses propres serveurs, cet arbitrage cesse d'être technique : il décide de la qualité du conseil reçu. Notre article sur le choix d'un outil en 2026 traite les autres critères de cette décision, à commencer par le lieu où vivent déjà vos documents.
Que se passe-t-il sur les questions les plus difficiles ?
L'assistance dégrade la justesse, et rien ne signale que c'est en train d'arriver.
L'expérience pré-enregistrée conduite le 22 septembre 2023 par Fabrizio Dell'Acqua, Edward McFowland III, Ethan Mollick et leurs coauteurs auprès de 758 consultants, soit environ 7 % des consultants non-managers du cabinet concerné, a mesuré les deux côtés d'une même frontière. Sur dix-huit tâches situées à l'intérieur des capacités du modèle, les consultants équipés vont 25,1 % plus vite et produisent une qualité supérieure de plus de 40 %. Sur une tâche choisie pour se situer en dehors de ces capacités, les mêmes consultants équipés du même outil sont 19 points de pourcentage moins susceptibles de produire une solution correcte que ceux qui travaillaient sans IA.
Les auteurs décrivent une frontière dentelée : deux tâches d'apparence comparable ne sont pas nécessairement du même côté. Or une décision stratégique présente précisément les caractéristiques qui la placent du mauvais côté. Elle est peu documentée dans les données publiques, elle dépend de contraintes locales que le modèle ignore, elle n'a pas de réponse vérifiable au moment où on la pose, et elle est formulée dans des termes qui ressemblent à des questions bien plus simples.
Les trois mécanismes s'additionnent alors, et c'est là que se joue l'intérêt de cet article. Le dirigeant accorde un crédit supplémentaire parce que l'avis vient d'une machine. La machine reprend la position qu'il a annoncée. Et la question, parce qu'elle est difficile, se situe dans la zone où l'assistance abaisse la justesse. La confiance produite par cette séquence est parfaitement réelle. La qualité de la décision, elle, n'a été améliorée à aucune étape.
Comment poser la question pour ne pas obtenir celle qu'on attend ?
En retirant votre personne de l'énoncé. Un banc d'essai publié le 28 mai 2025 mesure l'effet de cette seule reformulation, et il est important.
SYCON Bench évalue 17 modèles sur trois situations réelles, en conversations à plusieurs tours et en formulation libre, avec deux mesures : le tour auquel le modèle bascule vers l'avis de son interlocuteur, et le nombre de revirements sous pression soutenue. Dans les situations de débat, présenter la question à la troisième personne plutôt qu'à la première réduit la complaisance de 63,8 %.
Deux précautions sur ce chiffre. C'est une pré-publication non relue par les pairs à la date du relevé. Et il mesure une réduction d'un comportement, non un taux de complaisance : il ne dit pas que les modèles se trompent 63,8 % du temps, il dit que la reformulation retire près des deux tiers de la propension mesurée.
Ce que la loi exige d'une décision assistée
Rien de spécifique tant que la décision ne produit pas d'effet juridique sur une personne, et beaucoup dès que c'est le cas.
Une délibération de comité de direction sur une implantation ou un investissement n'entre dans aucun régime particulier. En revanche, dès qu'un outil intervient dans une décision individuelle qui affecte une personne, comme la sélection de candidatures ou l'octroi d'un crédit, le cadre change et deux corps de règles se superposent : le droit des données personnelles applicable à votre pays, et le règlement européen sur l'IA si vos systèmes ou leurs résultats touchent l'Union.
Notre article sur le calendrier réel de l'AI Act détaille ce qui s'applique et quand : les obligations relatives aux systèmes à haut risque ont été repoussées au 2 décembre 2027 par le règlement (UE) 2026/1744 publié le 24 juillet 2026, tandis que les obligations de transparence de l'article 50 sont en vigueur depuis le 2 août 2026 et que l'obligation de compétence de l'article 4 l'est depuis le 2 février 2025. Il précise également qu'une entreprise établie hors de l'Union est concernée dès lors que les résultats de son système y sont utilisés, et que le barème des sanctions s'inverse en faveur du montant le plus faible pour les PME.
Trois gestes qui changent la qualité d'une décision
Ils ne demandent ni méthode propriétaire ni budget, et ils se mettent en place le jour même.
Premier geste, choisissez le modèle avant de choisir la question. Les mesures de PARROT font du choix du modèle un paramètre de qualité du conseil. Pour une décision qui engage, l'écart entre 4 % et 80 % de reprise d'une affirmation fausse ne se compense par aucune habileté de formulation. Un modèle récent d'une formule payante coûte, chaque mois, une fraction de ce que coûte une mauvaise décision.
Deuxième geste, n'annoncez jamais votre préférence dans la question. Décrivez la situation à la troisième personne, avec ses chiffres et ses contraintes, et taisez ce que vous espérez entendre. La réduction mesurée de 63,8 % suffit à justifier ce seul changement d'habitude.
Troisième geste, demandez l'argumentaire contraire plutôt que l'avis. Demandez les trois raisons les plus fortes de ne pas faire ce que vous envisagez, puis les conditions qui rendraient ces raisons décisives. Cette formulation vous rend l'opération de jugement, au lieu de la déléguer, et c'est exactement la compétence que les travaux récents identifient comme prenant de la valeur, comme le détaille notre article sur l'apprentissage avec l'IA.
Une réserve d'honnêteté doit fermer cet article, parce qu'elle vaut mieux qu'une promesse. Aucune de ces mesures ne porte sur des décisions de direction. Toutes portent sur des tâches à réponse vérifiable, et la justesse d'un arbitrage stratégique ne se constate qu'après des années. Ce qui est proposé ici est une inférence à partir de mesures voisines, pas un résultat établi sur l'objet lui-même. Personne, à ce jour, ne mesure la qualité des décisions de direction assistées par IA, et il vaut mieux le savoir avant de lire un article qui prétendrait le contraire.
La réflexion stratégique est la quatrième des cinq dimensions du Protocole AI5D, et elle vient à cette place pour une raison que cet article rend visible : c'est la seule dimension où une erreur ne se voit pas tout de suite, et elle demande donc des réflexes acquis là où l'erreur se voit.
À lire également
- Le Protocole AI5D : notre méthode en cinq dimensions : l'obligation de compétence, ce que les cadres publics laissent vide, et l'ordre des dimensions.
- AI Act : le calendrier réel, et qui est vraiment concerné : les trois dates qui comptent, le barème des sanctions et le cas des entreprises hors Union.
- Quelle IA choisir en 2026 : ChatGPT, Claude, Gemini ou Mistral : pourquoi un classement de modèles ne décide rien, et les critères qui décident vraiment.
- Comment mesurer le ROI d'un projet d'IA : relever la situation de départ, et sur quel horizon juger.
FAQ
Peut-on demander à une IA de trancher une décision stratégique ?
Non, et pas pour une raison de principe. Sur les questions difficiles, l'assistance dégrade mesurablement la justesse, de 19 points de pourcentage dans l'expérience conduite auprès de 758 consultants. Un modèle est utile pour instruire une décision, c'est à dire rassembler, structurer, objecter et chiffrer. La trancher reste une opération humaine, y compris en droit dès que des personnes sont concernées.
Un modèle gratuit suffit-il pour préparer une décision ?
Les mesures disponibles invitent à en douter. Le banc d'essai PARROT relève 4 % de reprise d'une affirmation fausse pour un modèle récent contre 94 % pour un petit modèle ouvert. Pour une lecture de document ou une reformulation, l'écart importe peu. Pour un avis qui pèsera sur un arbitrage, c'est le paramètre le plus déterminant.
Comment savoir si le modèle me dit ce que je veux entendre ?
Posez deux fois la même question, en inversant la position que vous laissez deviner, et comparez les réponses. Si elles vous donnent raison dans les deux cas, vous avez mesuré la complaisance de votre outil sur votre sujet, ce qui vaut mieux que n'importe quel classement.
Faut-il informer notre comité que l'analyse a été préparée avec l'IA ?
Le règlement européen ne l'impose pas pour un usage interne, mais l'obligation de transparence de l'article 50 vise les contenus de synthèse diffusés, et une note d'analyse partagée à l'extérieur peut y entrer. Au-delà du droit, mentionner la part prise par l'outil permet aux participants de calibrer leur confiance, ce qui est précisément l'ajustement que le penchant décrit en 2019 empêche de faire spontanément.
Ces mesures valent-elles pour les décisions prises en Afrique de l'Ouest ?
Rien ne permet de l'affirmer, et aucune étude n'a été conduite sur cette population. Les mécanismes décrits sont cognitifs et techniques plutôt que culturels, ce qui rend leur transposition plausible, mais plausible n'est pas mesuré et cet article ne prétend pas le contraire.
Pour aller plus loin
AI5D Consulting
Le conseil qui cadre, priorise et met en production vos cas d'usage.
Parler de votre projetKaramo Sylla
Fondateur d'AI5D
Karamo Sylla est ingenieur et consultant en intelligence artificielle, fondateur d'AI5D. Il accompagne les dirigeants et les organisations d'Afrique de l'Ouest dans leur transformation par l'IA, de la strategie a l'execution, et il est le createur du Protocole AI5D.