Comment gagner vraiment du temps avec l'IA
Sur cette page
- L'essentiel
- Que mesurent réellement les essais qui annoncent des gains massifs ?
- Pourquoi un autre essai mesure-t-il un ralentissement de 19 % ?
- Qui gagne réellement du temps, et qui n'en gagne pas ?
- Pourquoi le gain s'inverse-t-il sur les tâches les plus difficiles ?
- Combien une organisation économise-t-elle réellement en une semaine ?
- Comment situer vos propres tâches ?
- À lire également
- FAQ
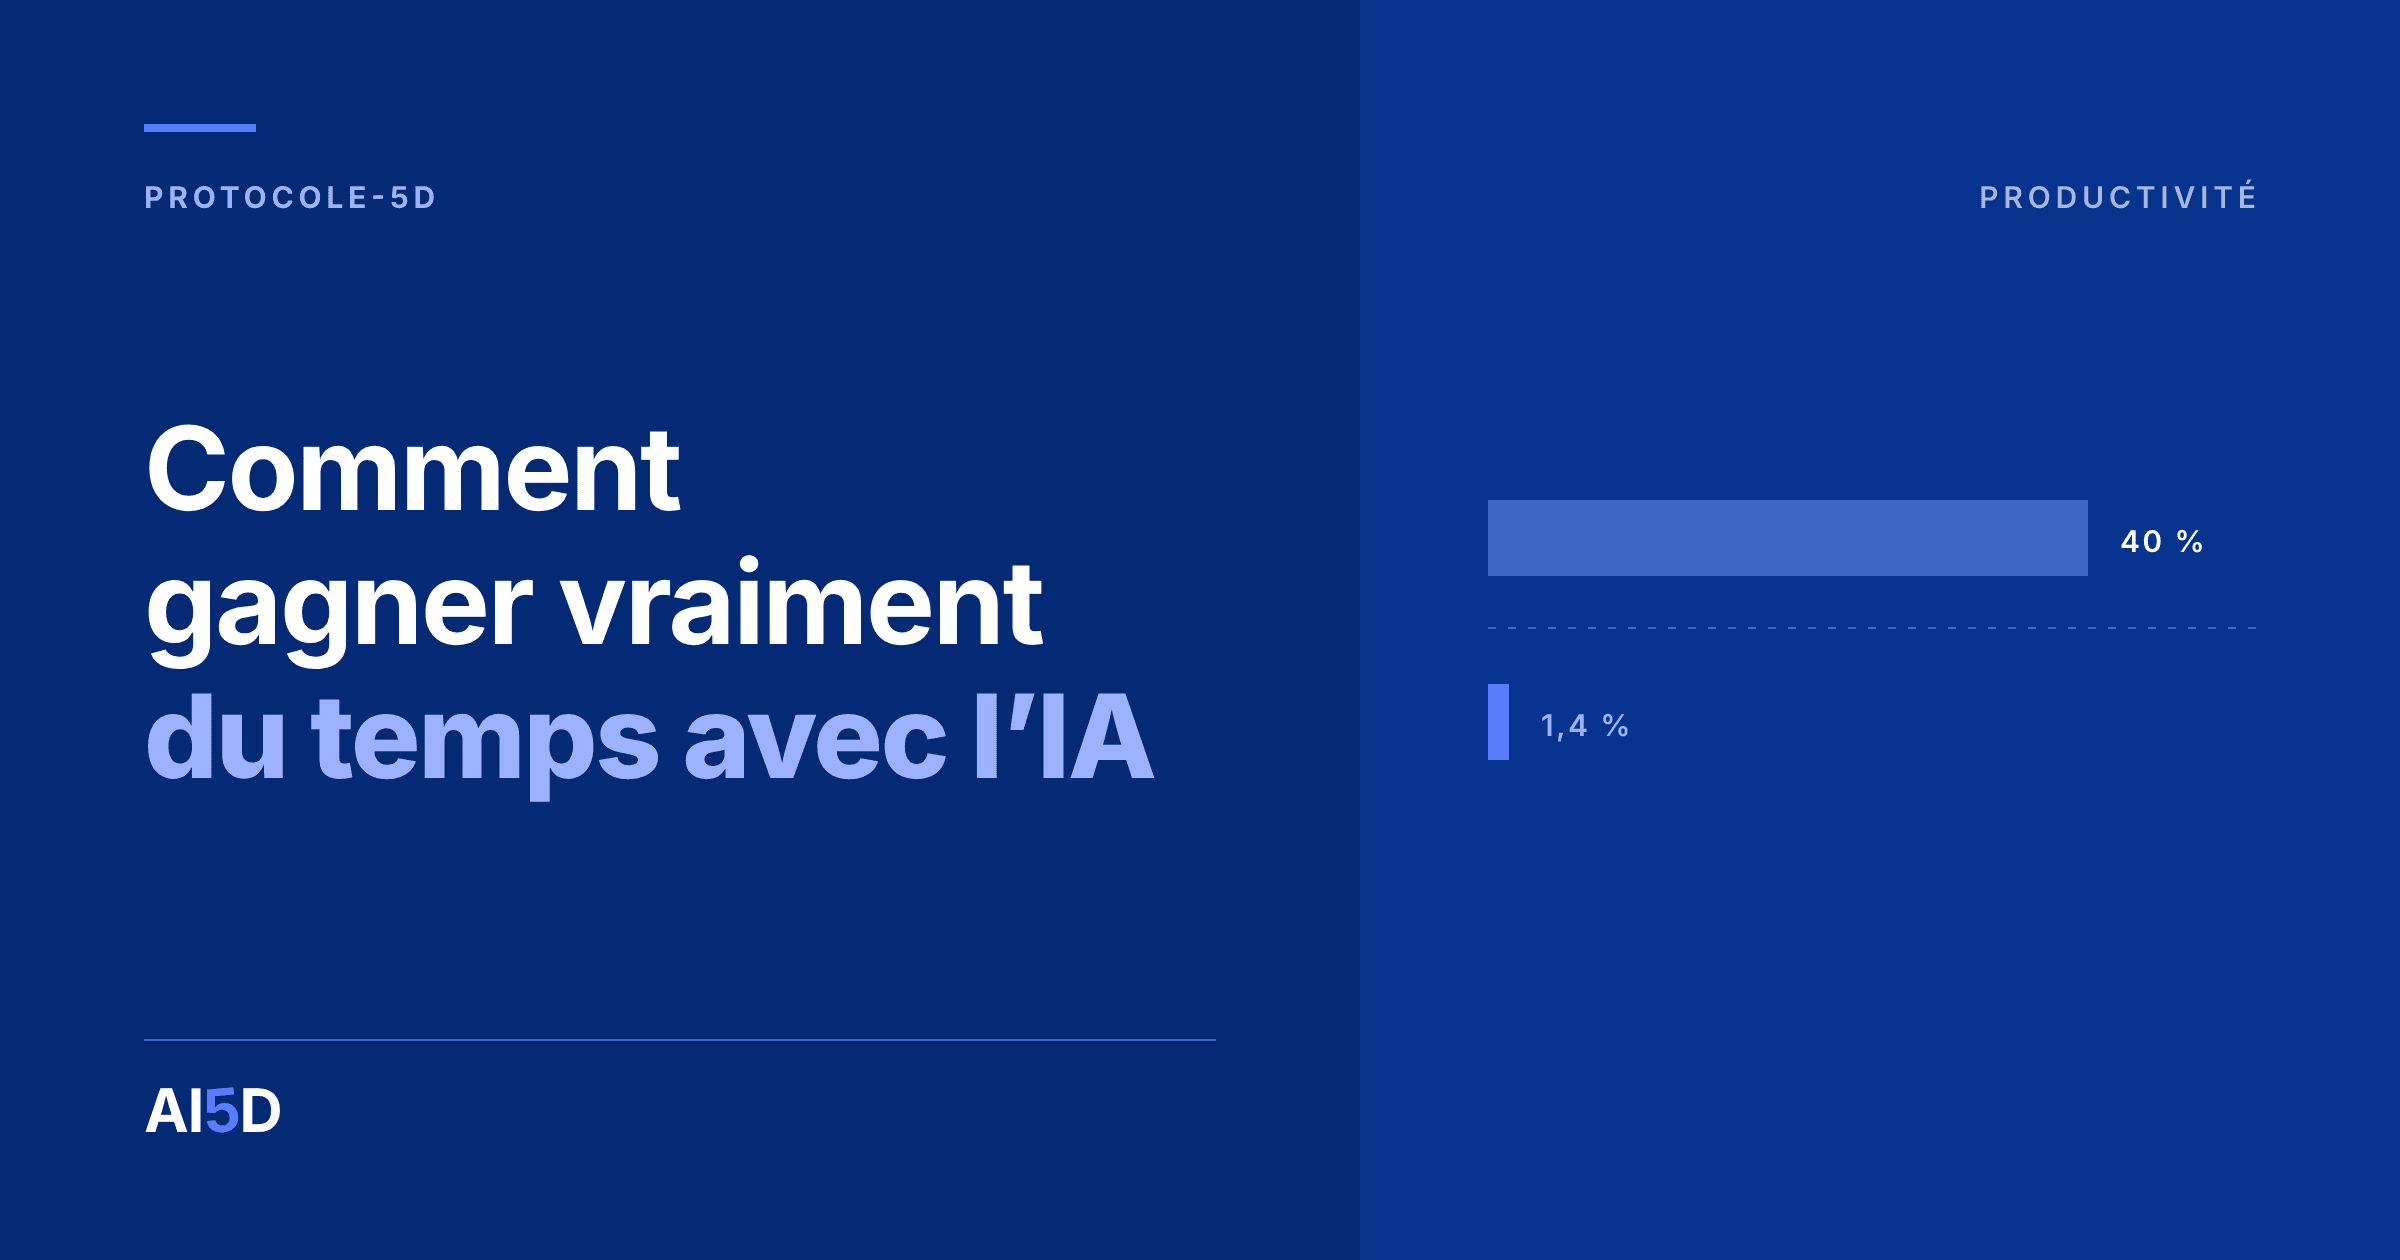
L'essai randomisé de Shakked Noy et Whitney Zhang, publié dans Science en juillet 2023 auprès de 453 professionnels diplômés, mesure une réduction de 40 % du temps passé sur des tâches d'écriture de niveau intermédiaire, avec une qualité en hausse de 18 %. L'enquête nationalement représentative d'Alexander Bick, Adam Blandin et David Deming, conduite auprès de plus de dix mille personnes en août et novembre 2024 et révisée en février 2025, relève de son côté une économie de temps équivalente à 1,4 % des heures travaillées, soit environ vingt-neuf minutes sur une semaine de trente-cinq heures.
Ces deux chiffres sont exacts et ils ne se contredisent pas, parce qu'ils ne mesurent pas le même objet. Le premier mesure ce qu'un outil produit sur une tâche choisie pour lui, le second ce qu'une population entière en retire dans son travail ordinaire. L'écart entre les deux n'est pas un problème de méthode, c'est le sujet : le gain de temps n'est pas une propriété de l'outil, c'est une propriété du couple formé par une personne et une tâche.
Cet article détaille ce que mesurent réellement les essais qui annoncent des gains massifs, pourquoi un autre essai mesure un ralentissement chez des experts, qui gagne du temps et qui n'en gagne pas, pourquoi le gain s'inverse sur les tâches les plus difficiles, ce qu'une organisation économise réellement à l'échelle d'une semaine, et comment situer vos propres tâches sans attendre qu'une étude le fasse pour vous.
L'essentiel
Cinq essais contrôlés randomisés documentent ce sujet, et ils convergent sur deux variables plutôt que sur un chiffre. La première est l'écart entre la personne et la tâche : le gain est maximal chez les moins expérimentés et minimal, voire négatif en qualité, chez les plus expérimentés, ce que trois équipes indépendantes trouvent sur trois métiers différents. La seconde est la position de la tâche par rapport aux capacités du modèle : sur une tâche que le modèle traite bien, des consultants gagnent 25,1 % de vitesse ; sur une tâche voisine qu'il traite mal, les mêmes consultants équipés du même outil sont 19 points moins susceptibles de produire une réponse correcte. À l'échelle d'un pays, l'économie déclarée tombe à 1,4 % des heures travaillées, et une partie du gain individuel se transfère en coût sur les collègues. La conséquence pour une organisation est qu'on ne déploie pas uniformément : on cible.
Que mesurent réellement les essais qui annoncent des gains massifs ?
Ils mesurent l'effet d'un outil sur une tâche choisie pour être à sa portée, chez des personnes qui ne sont pas expertes de cette tâche, et les gains qu'ils rapportent sont réels.
L'essai de Noy et Zhang confie à 453 professionnels diplômés des tâches d'écriture incitées et propres à leur métier, la moitié d'entre eux ayant accès à un assistant conversationnel. Le temps moyen baisse de 40 %, la qualité évaluée monte de 18 %. Deux observations des auteurs comptent autant que ces chiffres. La première est que l'outil comprime la distribution : il profite davantage aux moins performants et réduit l'écart entre travailleurs. La seconde est qu'il se substitue à l'effort plutôt qu'il ne complète la compétence, en déplaçant la tâche vers la production d'idées et la relecture au détriment du premier jet.
Le second essai porte sur un terrain bien plus large. Erik Brynjolfsson, Danielle Li et Lindsey Raymond suivent le déploiement échelonné d'un assistant conversationnel auprès de 5 172 agents de support client, et publient leurs résultats dans le Quarterly Journal of Economics en 2025. La productivité, mesurée en dossiers résolus par heure, progresse de 15 % en moyenne. Leur résumé ajoute immédiatement une réserve que les reprises omettent presque toujours : cette moyenne recouvre une hétérogénéité considérable entre travailleurs.
Deux effets secondaires méritent d'être signalés pour une organisation ouest-africaine, parce qu'ils ne relèvent pas du gain de temps et qu'ils sont souvent les plus utiles en pratique : les auteurs constatent que l'assistance facilite l'apprentissage des agents et améliore leur aisance en anglais, en particulier chez les agents internationaux.
Pourquoi un autre essai mesure-t-il un ralentissement de 19 % ?
Parce qu'il porte sur des experts travaillant sur leur propre terrain, c'est à dire sur le cas exactement opposé à celui des essais précédents.
L'organisme d'évaluation METR a publié le 10 juillet 2025 un essai conduit auprès de seize développeurs expérimentés, sur 246 tâches réelles tirées de leurs propres dépôts, des projets comptant en moyenne plus de vingt-deux mille étoiles et plus d'un million de lignes de code. Chaque tâche était tirée au sort avec ou sans autorisation d'utiliser l'IA. Le résultat mesuré est un ralentissement de 19 %.
Le chiffre le plus intéressant de cet essai n'est pourtant pas celui-là.
24 %
de gain de vitesse attendu par les développeurs avant l'essai
19 %
de ralentissement effectivement mesuré
20 %
de gain encore estimé après avoir fait le travail
Source : METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 10 juillet 2025.
Trente-neuf points séparent le gain perçu du gain mesuré, et l'écart ne se corrige pas par l'expérience de la tâche : les participants continuaient de croire qu'ils avaient gagné du temps après en avoir perdu. Les auteurs déclarent eux-mêmes ne pas prétendre que leur population représente la majorité du développement logiciel, ne rien établir hors de ce métier, et ne pas exclure un effet d'apprentissage qui n'apparaîtrait qu'après plusieurs centaines d'heures d'usage. Ces réserves ne diminuent pas le résultat, elles en fixent le périmètre.
Pour une direction, la conséquence est immédiate et elle est inconfortable : un sondage interne de satisfaction, un retour d'atelier ou un tour de table ne mesurent pas un gain de temps. Ils mesurent une croyance sur ce gain, et cette croyance est documentée comme peu fiable.
Qui gagne réellement du temps, et qui n'en gagne pas ?
Les moins expérimentés gagnent beaucoup, les plus expérimentés gagnent peu et perdent parfois en qualité, et trois équipes indépendantes trouvent cette même courbe sur trois métiers sans rapport.
| Essai, métier | Population la moins qualifiée | Population la plus qualifiée |
|---|---|---|
| Noy et Zhang, écriture professionnelle, Science, juillet 2023 | gain le plus fort, compression de la distribution | gain plus faible |
| Brynjolfsson, Li et Raymond, support client, QJE, 2025 | progression en vitesse et en qualité | faible gain de vitesse, légère baisse de qualité |
| Dell'Acqua et coauteurs, conseil, expérience pré-enregistrée du 22 septembre 2023 | +43 % par rapport à leur propre score de départ | +17 % par rapport à leur propre score |
Sources : les trois publications d'origine, relevées le 19 août 2026.
Cette convergence est le résultat le plus solide du dossier, parce qu'elle ne vient pas d'une réplication mais de trois protocoles différents sur trois populations sans lien. L'essai de METR ne fait pas exception à cette courbe : il en occupe le point extrême, celui où la population étudiée est composée uniquement d'experts travaillant sur la matière qu'ils connaissent le mieux au monde.
La conséquence de gestion est contre-intuitive. Beaucoup d'organisations équipent d'abord leurs profils les plus seniors, par souci de crédibilité interne ou parce que ce sont eux qui demandent l'outil. C'est précisément la population chez qui le gain mesuré est le plus faible, et la seule chez qui une dégradation de qualité est documentée. Les articles de cette collection consacrés aux sept tâches à automatiser dès ce mois-ci partent d'ailleurs de l'autre extrémité, celle des tâches répétitives dont personne ne revendique l'expertise.
Pourquoi le gain s'inverse-t-il sur les tâches les plus difficiles ?
Parce que les capacités d'un modèle ne forment pas un cercle mais une frontière dentelée, et que deux tâches d'apparence identique ne sont pas toujours du même côté.
L'expérience conduite par Fabrizio Dell'Acqua, Edward McFowland III, Ethan Mollick et leurs coauteurs avec Harvard Business School, Wharton, le MIT Sloan et le BCG Henderson Institute, pré-enregistrée et publiée le 22 septembre 2023, a porté sur 758 consultants, soit environ 7 % des consultants non-managers du cabinet. Les participants étaient tirés au sort entre trois conditions : sans IA, avec accès à GPT-4, ou avec accès à GPT-4 et une initiation à la formulation des consignes.
Sur dix-huit tâches de conseil situées à l'intérieur des capacités du modèle, les consultants équipés accomplissent 12,2 % de tâches en plus, vont 25,1 % plus vite, et produisent une qualité supérieure de plus de 40 %. Sur une tâche choisie pour se situer en dehors de ces capacités, les mêmes consultants équipés du même outil sont 19 points de pourcentage moins susceptibles de produire une solution correcte que ceux qui n'avaient pas d'IA du tout.
C'est le résultat le plus important de tout le sujet, et il est presque toujours omis. L'assistance ne devient pas neutre quand la tâche la dépasse : elle devient nuisible. Et rien dans l'interface ne signale de quel côté de la frontière se trouve la question posée, puisque le ton de la réponse ne varie pas avec sa justesse. C'est le même mécanisme que celui décrit dans notre article sur les réponses inventées, transposé du fait au raisonnement.
Combien une organisation économise-t-elle réellement en une semaine ?
Environ vingt-neuf minutes par personne sur une semaine de trente-cinq heures, selon la seule mesure disponible à l'échelle d'une population, et une partie de ce gain est reprise ailleurs.
L'enquête de Bick, Blandin et Deming est la seule source nationalement représentative sur ce sujet. Menée en août et novembre 2024 auprès de plus de dix mille personnes de dix-huit à soixante-quatre ans aux États-Unis, pondérée sur l'enquête officielle de population active, elle relève que près de 40 % de cette population utilise l'IA générative, que 23 % des personnes en emploi l'ont utilisée pour le travail au moins une fois dans la semaine écoulée, et que 9 % l'utilisent tous les jours ouvrés. Entre 1 % et 5 % de l'ensemble des heures travaillées sont assistées, et l'économie de temps déclarée équivaut à 1,4 % des heures travaillées.
Deux précautions s'imposent sur ce chiffre. La première est qu'il est déclaratif, donc précisément le type d'estimation que l'essai METR invite à considérer avec méfiance. La seconde est qu'un chiffre voisin de 5,4 %, souvent attribué à cette même source sur les pages qui agrègent des statistiques, ne figure pas dans la publication : le résumé du document de travail dit 1,4 %, et l'écart est d'un facteur presque quatre.
Il faut ensuite soustraire ce qui se perd. L'étude conduite par BetterUp Labs avec le Stanford Social Media Lab, publiée dans la Harvard Business Review en septembre 2025 auprès de 1 150 salariés de bureau à temps plein aux États-Unis, établit que 41 % d'entre eux ont reçu dans le mois écoulé un contenu produit par IA qui a l'apparence d'un travail abouti sans faire avancer la tâche, et qu'il leur a fallu en moyenne une heure et cinquante-six minutes pour le rattraper. C'est une enquête déclarative, et son extrapolation monétaire n'est pas une observation comptable, mais la fréquence, elle, est mesurée sur un échantillon sérieux.
Autrement dit, une partie du temps gagné par une personne réapparaît en temps perdu par une autre. C'est ce qui distingue un gain de productivité d'un simple déplacement de charge, et c'est ce qu'un tableau de bord d'usage ne verra jamais.
Comment situer vos propres tâches ?
En cessant de chercher un chiffre général, qui n'existe pas, et en mesurant les deux variables sur votre propre matière. La méthode tient en un mois et ne demande aucun outil supplémentaire.
Semaine 1 : choisissez trois tâches et relevez leur durée réelle
Prenez trois tâches récurrentes, chronométrées sur leur déroulement actuel, sans IA. Choisissez-en une que vous maîtrisez parfaitement, une que vous faites correctement sans être expert, et une que vous confiez habituellement à quelqu'un de moins expérimenté. Notez la durée et un critère de qualité vérifiable par un tiers.
Semaine 2 : refaites-les avec l'outil, et chronométrez de nouveau
Même relevé, même critère de qualité, même personne. Ne demandez à personne son ressenti : c'est la seule consigne non négociable de ce protocole, et l'essai METR explique pourquoi.
Semaine 3 : cherchez la frontière
Reprenez la tâche où le gain a été le plus fort et durcissez-la progressivement, en ajoutant des contraintes réelles de votre métier. Le point où la qualité chute est votre frontière sur ce sujet. Elle ne ressemblera à celle de personne d'autre, et c'est bien pour cela qu'aucune étude ne peut vous la donner.
Semaine 4 : décidez qui équiper, et sur quoi
Les trois relevés donnent la réponse. Le gain se concentre sur les tâches que la personne ne maîtrise pas déjà et qui restent à l'intérieur de la frontière. Tout le reste est du déploiement décoratif, et notre article sur la mesure du retour d'un projet d'IA montre comment inscrire ces relevés dans un calcul défendable.
La productivité est la première des cinq dimensions du Protocole AI5D pour une raison que ce protocole rend visible : c'est la seule dimension dont le résultat se constate sans instrument. Du temps libéré se voit, à condition de l'avoir relevé avant.
À lire également
- Le Protocole AI5D : notre méthode en cinq dimensions : l'obligation de compétence, ce que les cadres publics laissent vide, et l'ordre des cinq dimensions.
- Les 7 tâches que vous pouvez automatiser dès ce mois-ci : les tâches répétitives par lesquelles commencer, avec leur ordre de grandeur.
- Vos équipes utilisent déjà l'IA, avec ou sans vous : l'inventaire des usages non décidés, préalable à toute mesure.
- Comment mesurer le ROI d'un projet d'IA : ce qui entre au numérateur et au dénominateur, et comment relever la situation de départ.
FAQ
Combien de temps l'IA fait-elle gagner en moyenne ?
Cette question n'a pas de réponse utilisable, et c'est le point de l'article. Les mesures vont de 40 % de temps en moins sur des tâches d'écriture à 19 % de temps en plus chez des développeurs experts, avec le même type d'outil. La seule moyenne à l'échelle d'une population, celle de l'enquête américaine de février 2025, donne 1,4 % des heures travaillées, ce qui ne décrit correctement le cas de personne.
Faut-il équiper d'abord les collaborateurs les plus expérimentés ?
Les données disent l'inverse. Dans les trois essais qui mesurent le gain selon le niveau initial, les personnes les moins qualifiées progressent le plus, et les plus qualifiées sont les seules chez qui une légère baisse de qualité est observée. Cela ne veut pas dire qu'il faut exclure vos seniors, mais que le gain de temps ne viendra pas de là.
Comment savoir si une tâche est à la portée du modèle ?
En la durcissant progressivement et en observant où la qualité chute, ce que la méthode en quatre semaines décrit. Aucun éditeur ne publie la carte de cette frontière, et elle se déplace à chaque nouvelle version de modèle, ce qui oblige à refaire le relevé une ou deux fois par an plutôt qu'une fois pour toutes.
Nos équipes disent gagner beaucoup de temps, est-ce suffisant ?
Non, et c'est le résultat le plus solide du sujet. Dans l'essai METR, les participants prévoyaient 24 % de gain, en estimaient 20 % après coup, et avaient en réalité perdu 19 %. Un ressenti positif est une information utile sur l'adhésion de vos équipes, il n'en est aucune sur le temps réellement économisé.
Le gain de temps se traduit-il automatiquement en économie ?
Non, pour deux raisons. Le temps libéré doit être réaffecté à quelque chose, faute de quoi il ne produit rien de mesurable. Et une partie du gain se transfère en charge sur les collègues, comme l'établit l'enquête publiée dans la Harvard Business Review en septembre 2025 : 41 % des salariés interrogés ont reçu dans le mois un contenu généré qu'il a fallu près de deux heures pour rattraper.
Pour aller plus loin
Programme Leaders
Le programme pour dirigeants qui veulent decider de l'IA plutot que la subir.
Voir le programmeKaramo Sylla
Fondateur d'AI5D
Karamo Sylla est ingenieur et consultant en intelligence artificielle, fondateur d'AI5D. Il accompagne les dirigeants et les organisations d'Afrique de l'Ouest dans leur transformation par l'IA, de la strategie a l'execution, et il est le createur du Protocole AI5D.